14 Ekim 2026 ÇarşambaSayı № 287

Bölüm III

Benchmark

Skorlar konuşur

Test sonuçları, liderlik tabloları ve modellerin karşılaştırmalı performansı.

31 haber · son haber 13 Ekim

III Benchmark

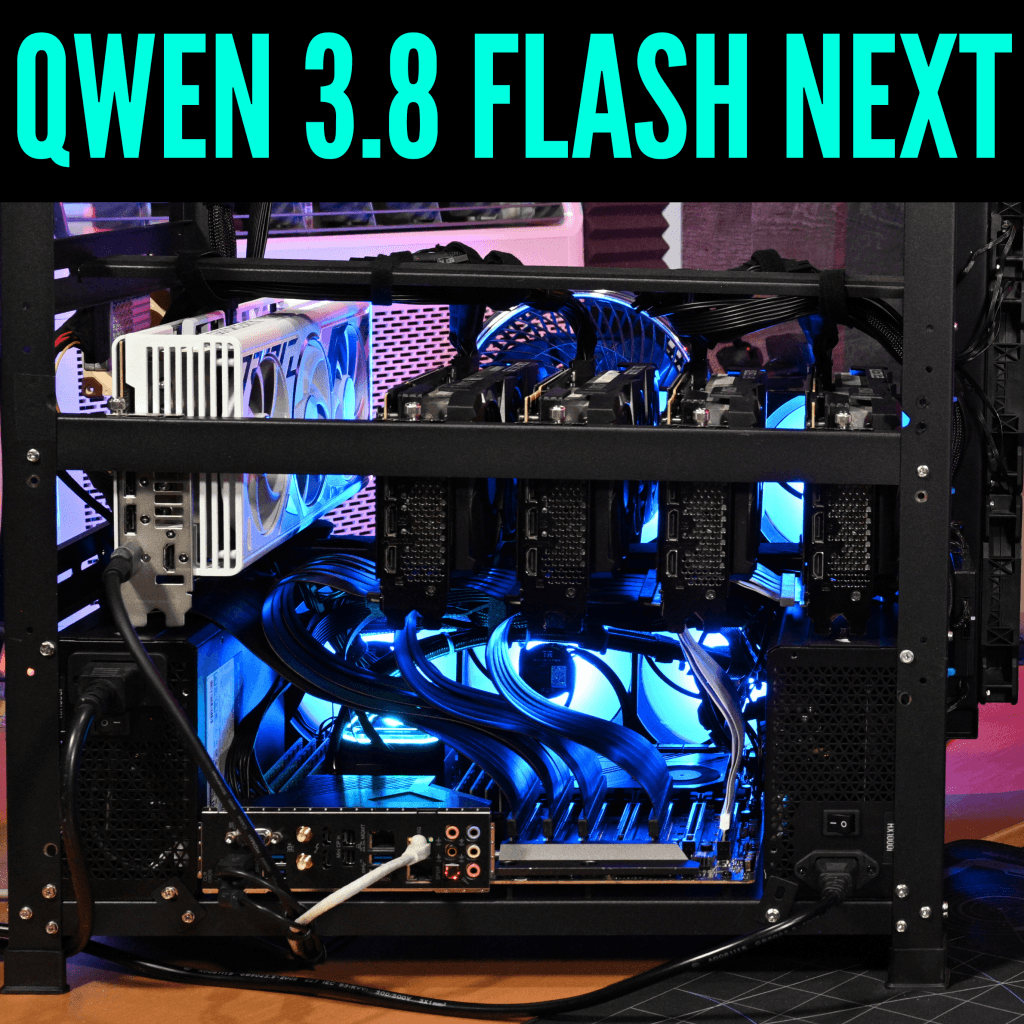
Horsey Challenge – Strata Fork ve Qwen 3.8 FN NVFP4

Kullanıcı, sergqwer'in Strata NVFP4 çatallı sürümünü RTX 5090 üzerinde çalıştırarak Qwen3.8-Flash-Next modelini 87 adımda bir 3D at animasyonu üretmek için test etti. Toplam 33 dakika 45 saniyelik bir duvar süresi, %99 önbellek hit oranı ve ortalama 116 token/sn decode hızı elde edildi. Sonuç, tek bir tüketici sınıfı GPU ile büyük MoE modellerinin karmaşık görevleri yerine getirebileceğini gösteriyor.

Özetle 3 madde
  1. Qwen3.8 modeli NVFP4 formatında RTX 5090 32 GB GPU üzerinde tek başına çalıştırıldı.
  2. Toplam 33 dakika 45 saniyede 87 adımda 124 443 çıktı token'ı üretildi.
  3. Cache hit oranı %99, decode hızı medyan 116 token/sn, prefill hızı ortalama 3 332 token/sn.
III

Bölümdeki haberler

III Benchmark

RTX 3090 FE sahiplerine uyarı: LLM çalıştırmak VRAM'ı aşırı ısıtıyor

RTX 3090 Founders Edition kartları, büyük dil modelleri (LLM) token üretirken VRAM sıcaklıklarının 112 °C'ye kadar yükseldiğini gösterdi. Kullanıcı, güç sınırını 270 W'ye düşürüp fanı %100 yaparak sıcaklığı 96 °C altında tutabildi ancak bu işlem %30 performans kaybına yol açtı. Undervolting ise sıcaklık sorununu çözmedi.

Özetle 3 madde
  1. RTX 3090 FE'de LLM token üretimi sırasında VRAM sıcaklığı 112 °C'ye ulaşabiliyor.
  2. Güç sınırını 270 W'ye düşürüp fanı %100 yaparak sıcaklık 96 °C'nin altına çekilebilir, ancak bu %30 performans kaybına yol açar.
  3. Undervolting düşük güç seviyelerinde etkili değil; saat hızı yalnızca 300 W üzerindeki güçlerde devreye giriyor.
III Benchmark

LocalLLama önerisiyle Qwen Flash Next için n+2 lookahead tahmini uygulandı, %8 sohbet ve %4,2 kod performansı sağladı

Mac Mini M5 64 GB üzerinde SSD streaming ile Qwen Flash Next'i optimize eden bir geliştirici, LocalLLama topluluğunun tavsiyesiyle iki katman önceden uzmanları yükleyen n+2 lookahead yöntemi kullandı. Bu yöntem sohbet görevlerinde %8, kod üretiminde ise %4,2 performans artışı getirdi.

Özetle 3 madde
  1. n+2 lookahead tahmini, Qwen Flash Next'in SSD streaming performansını %8 sohbet ve %4,2 kod iyileştirmesiyle artırdı.
  2. LocalLLama topluluğunun önerisi ve sdroege_ kullanıcısının orijinal katkısı sayesinde teknik geliştirme sağlandı.
  3. GitHub'da bulunan Flash-next-ssd projesi üzerinden uygulanabilir bir çözüm sunuldu.
III Benchmark

Dodaios: Açık kaynak masaüstü AI ajan uygulaması, yerel Ollama modelleriyle çalışıyor

Dodaios, Apache 2.0 lisanslı bir masaüstü AI ajan platformu, Windows, macOS ve Linux’da yerel Ollama modelleriyle çalışıyor. Geliştirici, RTX 5070 Ti‑de 16 GB bellekle qwen3.5:9b ve qwen3.8‑16gb modellerini iki ayrı ajan için test etti; yanıt süreleri sırasıyla 71 saniye ve 116 saniye olarak ölçüldü.

Özetle 3 madde
  1. Dodaios, yerel Ollama modelleriyle çalışan, bulutsuz ve açık kaynak bir masaüstü AI ajan platformu.
  2. RTX 5070 Ti 16 GB GPU’da qwen3.5:9b modeli 71 saniye, qwen3.8‑16gb modeli 116 saniye sürede görevleri tamamladı.
  3. Yerel modeller araç (tool) çağrılarında başarısız oldu; 9 b modeli hiç araç çağırmadı, 16 gb modeli rutin listesini iki kez çağırdı ama kaydetme aracını çalıştırmadı.
III Benchmark

Qwen 3.8 Flash Next Q3 S Modeli Üzerinde Benchmark Sonuçları

Reddit kullanıcısı migsperez, AMD R9700 GPU ve 64 GB RAM ile Qwen3.8‑Flash‑Next IQ3_S modelini Opencode platformunda test etti ve modelin 90 tokens/s decode hızıyla 27 B modelin üç katı performans gösterdiğini duyurdu.

Özetle 3 madde
  1. Qwen3.8‑Flash‑Next IQ3_S, 90 tokens/s decode hızıyla 27 B modelin üç katı performans gösterdi.
  2. Test, AMD Radeon RX 9700 32 GB GPU ve 64 GB RAM üzerinde Strata aracılığıyla gerçekleştirildi.
  3. Prompt varyasyonları, özellikle "low poly" stilinde çokgenli bir plan talebiyle çıktıyı iyileştirdi.
III Benchmark

llama.cpp için P100 ve Qwen3.6 35B modeline özel optimizasyonlar

Reddit kullanıcısı Mrinohk, Tesla P100 GPU'ları ve Qwen3.6‑35B modeline yönelik olarak llama.cpp kod tabanına bir dizi donanım‑özel yama geliştirdi. Bu yamalar, özellikle decode aşamasında %70'e varan performans artışı sağlarken, 3090 tabanlı bir referans sistemde 125 token/s hızına ulaşılabildiğini gösteriyor.

Özetle 3 madde
  1. Tesla P100 GPU'ları için özel olarak geliştirilmiş llama.cpp yamaları, decode performansını %70'e varan oranlarda artırdı.
  2. 3090 GPU üzerinde Qwen3.8‑27B modeliyle yapılan testlerde yaklaşık 125 token/s decode hızı elde edildi.
  3. Optimizasyonlar, megakernel ve azaltılmış vocab tekniklerini birleştirerek bellek erişimini ve kernel verimliliğini iyileştirdi.
III Benchmark

16 GB VRAM ile Qwen3.8‑27B q4_0 ve 262k KV akışı: 80t/s ve 400t/s performans

Reddit kullanıcısı, 16 GB VRAM'li bir GPU’da Qwen3.8‑27B modelini q4_0 kuantizasyonu ve 262 k token KV önbelleğiyle çalıştırarak 80 token/s ve 400 token/s prompt performansı elde ettiğini paylaştı. Bu başarı, llama.cpp‑adaptive‑kv‑streaming çatallamasının özelleştirilmesiyle mümkün oldu ve düşük bellekli sistemlerde büyük modellerin kullanılabilirliğine yeni bir bakış açısı sundu.

Özetle 3 madde
  1. 16 GB VRAM'li bir GPU’da Qwen3.8‑27B modelini q4_0 kuantizasyonu ve 262 k KV önbelleğiyle çalıştırmak mümkün.
  2. llama.cpp‑adaptive‑kv‑streaming çatallaması, q4_0 desteği eklenerek bellek verimliliği artırıldı.
  3. MTP benchmark'ta 80 token/s, 262 k context'te 20 token/s ve 400 token/s prompt‑per‑second (pp) elde edildi.
III Benchmark

Qwen3.8-27B vs Frontier ve Diğer Modeller

Yerel LLM'ler arasında kodlama, veri analizi ve RAG (Retrieval‑Augmented Generation) performansını ölçen kapsamlı bir test, Qwen3.8‑27B'nin token kesintileri ve model boyutu açısından zorluklar yaşadığını, Frontier ve bazı ince ayarlı modellerin ise daha istikrarlı sonuçlar verdiğini ortaya koydu.

Özetle 3 madde
  1. Qwen3.8‑27B, token kesintileri ve kuantizasyon belirsizliği nedeniyle en çok sorun yaşayan model oldu.
  2. Frontier ve bazı ince ayarlı modeller Q4 seviyesinde istikrarlı performans sergiledi.
  3. Test, sadece modelin yeteneklerini değil, token sınırları ve kuantizasyon etkilerini de ölçerek gerçek dünya iş akışlarına uygunluk sağladı.
III Benchmark

BrokenML: Ajanlar Bozuk ML İşlerini Düzeltme Yeteneği Test Edildi

Zhebrak, PyTorch ve llama.cpp ortamlarında ortaya çıkan yaygın hataları onarmak için gereken erişim seviyesini ölçen BrokenML adlı bir benchmark geliştirdi. Üç farklı erişim düzeyi (sadece konfigürasyon ve kod, okuma‑only loglar ve tam root erişimi) üzerinden dokuz modelin performansı değerlendirildi.

Özetle 3 madde
  1. BrokenML, ajanların bozuk ML işlerini düzeltmek için hangi erişim seviyesine ihtiyaç duyduğunu ölçen ilk kapsamlı benchmark olarak sunuldu.
  2. Test senaryoları, gerçek dünyada sıkça rastlanan şekil uyumsuzlukları, OOM, checkpoint bozulması ve düşük throughput gibi hataları içeriyor.
  3. Üç erişim düzeyi (kod+konfig, kod+log, tam root) arasındaki performans farkı, tam sistem yetkisinin hâlâ kritik bir rol oynadığını ortaya koydu.
III Benchmark

Qwen, XLong görevler için elastik RL çerçevesi QwenGyre'yi duyurdu

Qwen, uzun vadeli ve karmaşık görevlerde yapay zeka ajanlarını eğitmek üzere tasarlanmış QwenGyre adlı yeni bir pekiştirmeli öğrenme (RL) çerçevesini tanıttı. Çerçeve, Elastic Scheduler ve Trajectory Processor adlı iki temel bileşenle GPU kaynaklarını dinamik olarak yönlendirerek eğitim süresini %44'e varan oranlarda kısaltıyor ve NL2RepoBench skorunu %52,5'ten %58,5'e yükseltiyor.

Özetle 3 madde
  1. Elastic Scheduler, GPU kaynaklarını dinamik yeniden tahsis ederek canlı yürütmeleri kesintisiz tutar ve %1.78‑%1.85 hız artışı sağlar.
  2. Trajectory Processor, dallanmış yürütmeleri ortak ön ek ağaçlarıyla birleştirerek eğitim örneklerini verimli ve tekrarsız hâle getirir.
  3. QwenGyre, Qwen3.8-2.4T-A95B ile NL2RepoBench skorunu %52,5'ten %58,5'e yükseltirken eğitim süresini %44 azaltıyor.
III Benchmark

Açık Kaynak AI Lider Tablosu: Makinenizde Çalıştırabileceğiniz En İyi Modelleri Gösteriyor

Jake Manger, kullanıcıların RAM ve GPU kapasitelerini girerek yerel olarak çalıştırabilecekleri yapay zeka modellerini sıralayan bir açık kaynak lider tablosu (whatmodel.sh) geliştirdi. Araç, 19.731 yayınlanmış benchmark sonucunu tek bir puana dönüştürerek modelleri karşılaştırıyor ve API tabanlı modellerle aynı skoru gösteriyor.

Özetle 3 madde
  1. whatmodel.sh, RAM ve GPU bilgisiyle yerel olarak çalıştırılabilecek modelleri puanlayıp sıralıyor.
  2. 19.731 yayınlanmış benchmark sonucundan tek bir skor üretiliyor; bu skor API modelleriyle aynı ölçekte karşılaştırılabiliyor.
  3. 32 GB RAM'li bir Mac, 4‑bit quantization ile Qwen3.8 27B modelini GPT‑5 seviyesinde bir skorla çalıştırabiliyor.
III Benchmark

Qwen3.8-Flash-Next modeli 6x3090’da vLLM ile 262k bağlam, 57 t/s tekil decode ve 206 t/s toplu performans gösterdi

vLLM'in özel bir dalı sayesinde Qwen3.8-Flash-Next modeli, altı adet RTX 3090 GPU üzerinde 262 000 tokenlık bağlamı GPU KV’da tutarak 6,5 k token/sn prefill ve tek kullanıcıda 57 token/sn decode hızı yakaladı. Yedi eşzamanlı kullanıcıda ise toplam 206 token/sn üretim sağlandı. Bu sonuçlar, modelin büyük bağlamları ve çoklu oturumları düşük bellek tüketimiyle yönetebileceğini gösteriyor.

Özetle 3 madde
  1. vLLM'in int8 KV desteği ve PLE tablosunun SSD’ye taşınması sayesinde 108 GB RAM tasarrufu sağlandı.
  2. Model 262 k tokenlık bağlamı GPU KV’da tutarak 6,5 k token/sn prefill ve tek oturumda 57 token/sn decode hızı elde etti.
  3. Yedi eşzamanlı kullanıcıda toplam 206 token/sn üretim sağlandı; kullanıcı başına hız düşüşü pipeline paralelism nedeniyle ortaya çıktı.
III Benchmark

Strix‑Llama yeni dal: Prompt işleme %21‑%54 daha hızlı Vulkan'dan, 128k'da ROCm çekirdeğinde 2,7×'ye kadar

Strix Halo kutusu için geliştirilmiş bir llama.cpp dalı, RDNA3.5 mimarisinde flash attention ve ön‑prefill iyileştirmeleri sayesinde prompt işleme süresini Vulkan tabanlı çözümlerden %21‑%54, stok ROCm çekirdeğinden ise %8‑%174 oranında hızlandırdı. 128 k token bağlamında en yüksek %88'lik hız artışı elde edilirken, çıktı kalitesi ROCm ile neredeyse aynı kaldı.

Özetle 3 madde
  1. Prompt işleme hızı RDNA3.5 dalında Vulkan'dan %21‑%54, ROCm'den %8‑%174 daha hızlı.
  2. 128 k bağlamda Qwen3.6 modelinde %88, Qwen3.8 modelinde %174 gibi çarpıcı ROCm karşılaştırmalı hız artışı.
  3. Çıktı kalitesi (KL divergence, perplexity) ROCm ile aynı seviyede, Vulkan'dan daha tutarlı.

12 / 30 haber