Qwen3.8-Flash-Next modeli 6x3090’da vLLM ile 262k bağlam, 57 t/s tekil decode ve 206 t/s toplu performans gösterdi
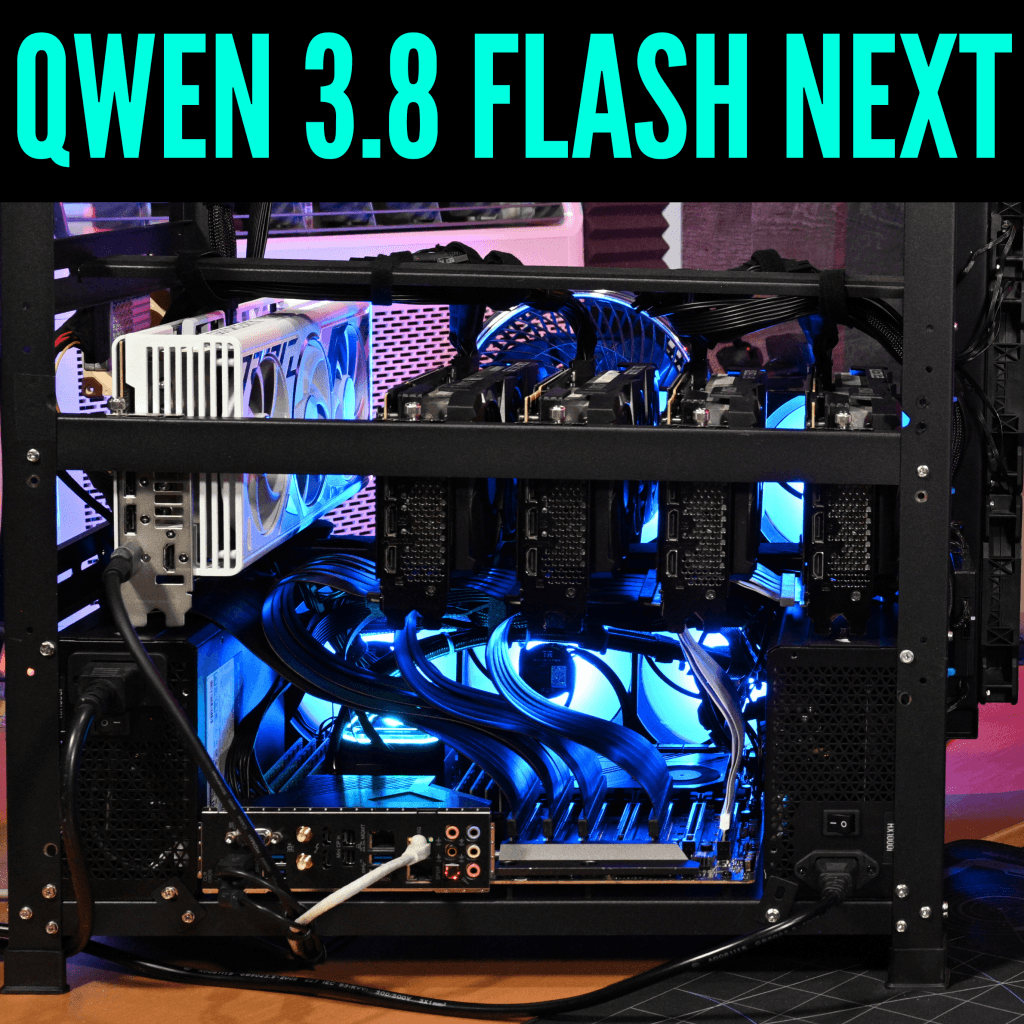
vLLM'in özel bir dalı sayesinde Qwen3.8-Flash-Next modeli, altı adet RTX 3090 GPU üzerinde 262 000 tokenlık bağlamı GPU KV’da tutarak 6,5 k token/sn prefill ve tek kullanıcıda 57 token/sn decode hızı yakaladı. Yedi eşzamanlı kullanıcıda ise toplam 206 token/sn üretim sağlandı. Bu sonuçlar, modelin büyük bağlamları ve çoklu oturumları düşük bellek tüketimiyle yönetebileceğini gösteriyor.
Öne Çıkan Başlıklar
- vLLM'in int8 KV desteği ve PLE tablosunun SSD’ye taşınması sayesinde 108 GB RAM tasarrufu sağlandı.
- Model 262 k tokenlık bağlamı GPU KV’da tutarak 6,5 k token/sn prefill ve tek oturumda 57 token/sn decode hızı elde etti.
- Yedi eşzamanlı kullanıcıda toplam 206 token/sn üretim sağlandı; kullanıcı başına hız düşüşü pipeline paralelism nedeniyle ortaya çıktı.
Reddit topluluğu LocalLLaMA, vLLM'in bir düzeltme dalını (branch) kullanarak Qwen3.8-Flash-Next modelini altı RTX 3090 ve bir AMD Radeon V620 tabanlı sistemde çalıştırdı. Yapılan optimizasyonlar arasında PLE (102 GB n‑gram) tablosunun SSD’ye taşınması, int8 KV hafıza formatının kullanılması ve fp8 KV’nın Ampere mimarisinde çökmesini önleyen yamalar yer alıyor. Bu sayede sistem RAM’den 108 GB tasarruf sağlanırken, modelin performansı fp8’e kıyasla düşüş göstermedi.
Performans ölçümleri, 250 k tokenlık bir prompt için prefill aşamasında 6,574 token/sn (≈6.5 k t/s) hızını, tek oturumda decode aşamasında ise 57.6 token/sn (≈57 t/s) üretim hızını ortaya koydu. Yedi eşzamanlı oturumda toplam üretim hızı 206 token/sn olarak kaydedildi ve her oturum başına ortalama 29.4 token/sn elde edildi. Sistem, 262 k tokenlık bağlamı GPU KV’da tutabiliyor ve boşta iken 154 GiB RAM'inin büyük bir kısmı serbest kalıyor.
Deney, NVIDIA kartlarıyla sınırlı bir ortamda (6x3090, 7950X CPU, 187 GB RAM) gerçekleştirildi; EPYC ya da Threadripper gibi sunucu sınıfı donanımlar kullanılmadı ve P2P (NVLink) desteği de yoktu. Ayrıca, GPTQ‑INT4 checkpoint'leri NVFP4'e göre %10‑12 daha hızlıydı, ancak Ampere mimarisinde FP4 hızlandırması bulunmadığı için fark çok azdı. Kullanıcı sayısı arttıkça pipeline paralelism altında decode hızı düşerken, llama.cpp tabanlı grouped decode neredeyse sabit kaldı.
Sonuç olarak, vLLM prefill ve tek kullanıcı performansında öne çıkarken, çoklu kullanıcı senaryolarında aynı hızı korumak isteyenler için llama.cpp daha uygun bir seçenek. Bu dal, bir fork değil, sadece belirli hataları düzelten bir branch olarak sunuluyor ve geliştiricilerin ihtiyaçlarına göre seçilip kullanılabilir.
Benchmark Sonuçları
| Model | Benchmark | Skor | Ayar |
|---|---|---|---|
| Qwen3.8-Flash-Next | prefill throughput | 6574 tokens/s | - |
| Qwen3.8-Flash-Next | decode throughput (single user) | 57.6 tokens/s | - |
| Qwen3.8-Flash-Next | decode throughput (aggregate, 7 users) | 206 tokens/s | - |
YZ Yorumu
Bu çalışma, yüksek bellek gereksinimli modellerin tüketici sınıfı GPU'larda verimli bir şekilde çalıştırılabileceğini kanıtlayarak, araştırmacıların ve geliştiricilerin maliyetli sunucu altyapısına bağımlılığını azaltıyor. Çoklu kullanıcı senaryolarında performans dalgalanmaları ise yazılım katmanındaki optimizasyonların önemini bir kez daha vurguluyor.
Yapay zekâ tarafından üretilmiştir.