10-16 GB VRAM Aralığında Çalışabilen LLM'ler Detaylı Sıralandı
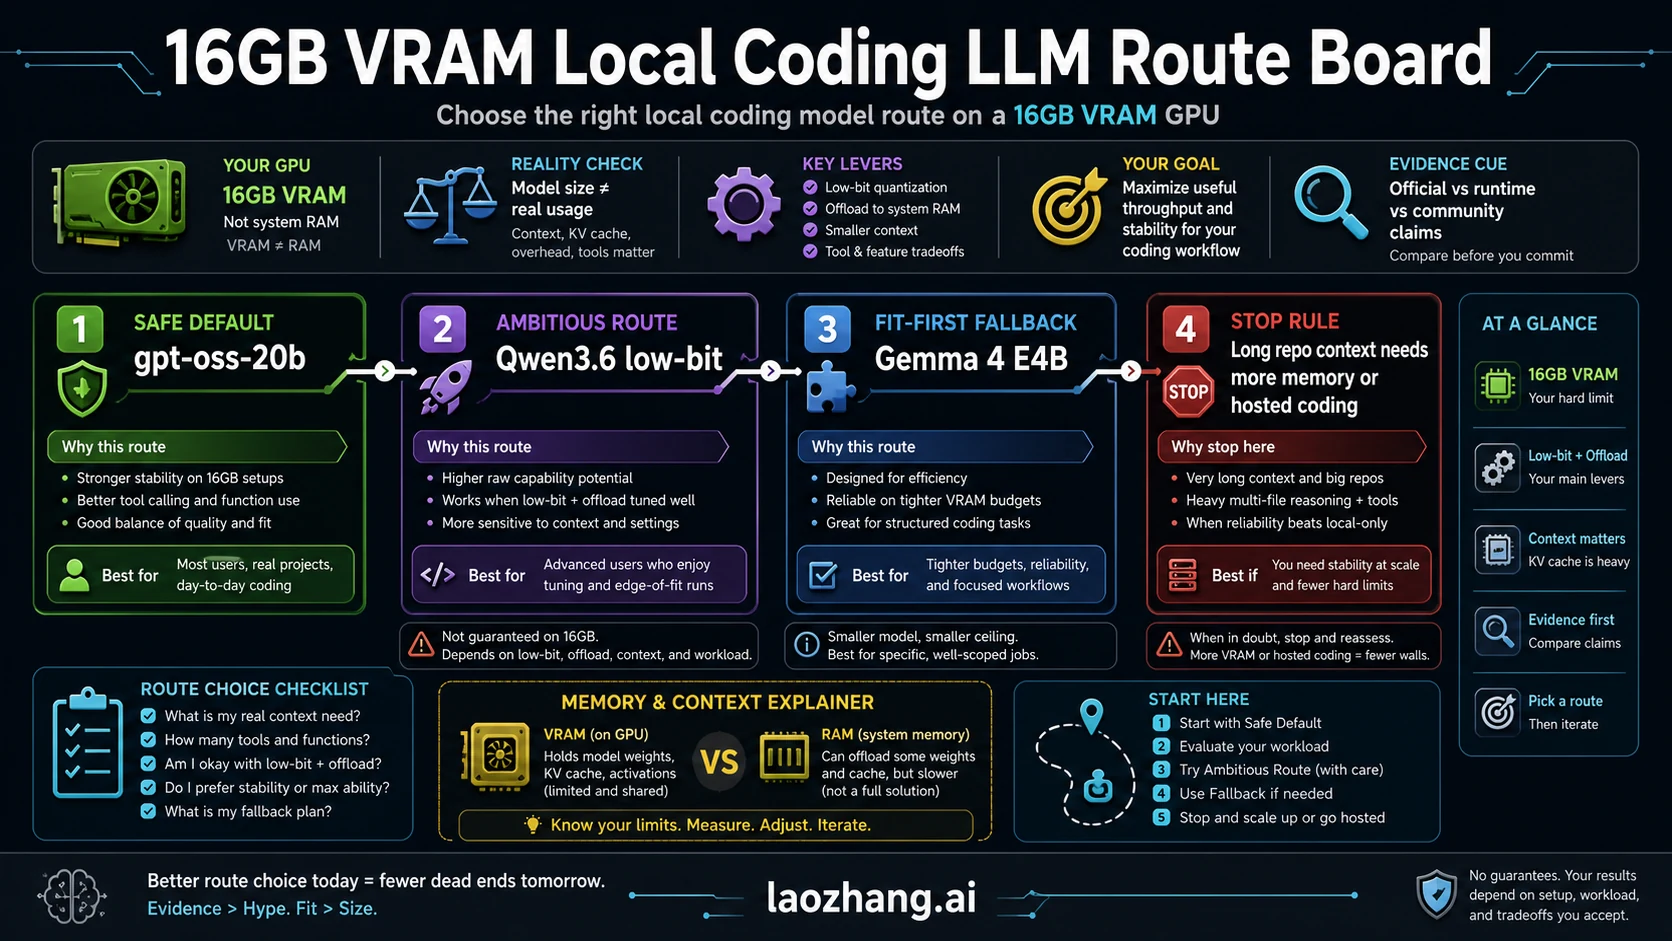
Reddit topluluğu LocalLLaMA, 10‑16 GB VRAM ve 26‑32 GB RAM gerektiren büyük dil modellerini hız, tutarlılık, dil nüansları ve talimat uyumu gibi kriterlere göre derecelendirdi. En yüksek puanı Gemma 4 26B‑A4B alırken, Qwen, GLM ve Mistral serileri de farklı güçlü yönleriyle listede yer aldı.
Öne Çıkan Başlıklar
- 10‑16 GB VRAM sınırında 64 k bağlam penceresi sunan modeller, FlashAttention ve SmartCache gibi optimizasyonlarla yüksek hızda çalışabiliyor.
- Gemma 4 26B‑A4B en yüksek puanı alırken, Qwen ve GLM serileri farklı yaratıcı ve mantıksal avantajlarla ikinci ve üçüncü sırada yer alıyor.
- 200 B üzeri modeller medya bilgisi bakımından belirgin üstünlük gösteriyor; 120 B modeller ise bu alanda eksik kalıyor.
Geçtiğimiz dört yılda ChatGPT gibi sohbet botları halüsinasyon yeteneklerinde ilerleme kaydetse de, topluluk üyeleri hâlâ düşük VRAM kapasiteli sistemlerde kullanılabilecek, 64 k bağlam penceresine sahip ve yaratıcı yanıtlar üretebilen modeller arıyor. Bu bağlamda, 10‑16 GB VRAM ve 26‑32 GB RAM sınırları içinde çalışan modeller, KoboldAI ya da LLAMA arayüzleri üzerinden test edildi.
Değerlendirme ölçütleri dört ana başlıkta toplandı: (1) Hız – saniyede en az 10 token üretme; (2) Tutarlılık – diyalog ve monologların mantıksal bütünlüğü; (3) Dil nüansları – yazım hataları, argo ve sert üslup gibi varyasyonları anlama yetisi; (4) Talimat uyumu – 23 karmaşık kuralı içeren “Pandora Instructions” gibi talimat setlerini sorunsuz işleyebilme. Censorship (reddetme oranı) düşük tutuldu; modellerin NSFL içeriklerde bile yanıt vermesi tercih edildi.
Sıralama, Gemma 4 26B‑A4B modelinin en üstte yer almasıyla başladı; ardından Qwen 35B‑A3B, Qwen 3.6 35B‑A3B, Gemma 4 Instruct 19B‑A1B ve The Omega Directive 14B gibi modeller geldi. GLM‑4.7‑Flash 31B‑A3B, Qwen3 30B A1.5B 64K ve çeşitli “Heretic”, “Uncensored” ve “Deckard” türevleri de performans, yaratıcılık ve tutarlılık açısından farklı avantajlar sundu. Özellikle 200 B üzeri modellerin anime, manga ve film gibi medya bilgisine sahip olduğu, 120 B modellerin ise bu veritabanını nadiren barındırdığı tespit edildi.
KoboldAI bazı modelleri yükleyemediği için Qwen 35B ve GLM 31B gibi büyük modellerin LLAMA arayüzüyle çalıştırılması önerildi. Ayrıca, 24 GB VRAM (ör. RTX 3090) sahip kullanıcılar için Omega Darker, Qwen3 24B‑A4B, Cydonia 24B gibi daha büyük modellerin alternatifleri listelendi. Test edilmemiş ya da performans açısından elenen modeller arasında Mistral 24B, GPT 20B OSS, Kimi K2 ve DeepSeek gibi popüler seçenekler de yer alıyor.
YZ Yorumu
Bu sıralama, düşük bellekli sistemlerde çalışan LLM'lerin seçiminde pratik bir yol haritası sunarak geliştiricilerin ve hobi kullanıcılarının performans‑fiyat dengesini daha iyi değerlendirmesine olanak tanıyor.
Yapay zekâ tarafından üretilmiştir.