Qwen3-0.6B Modeli MoE Formuna Dönüştürüldü
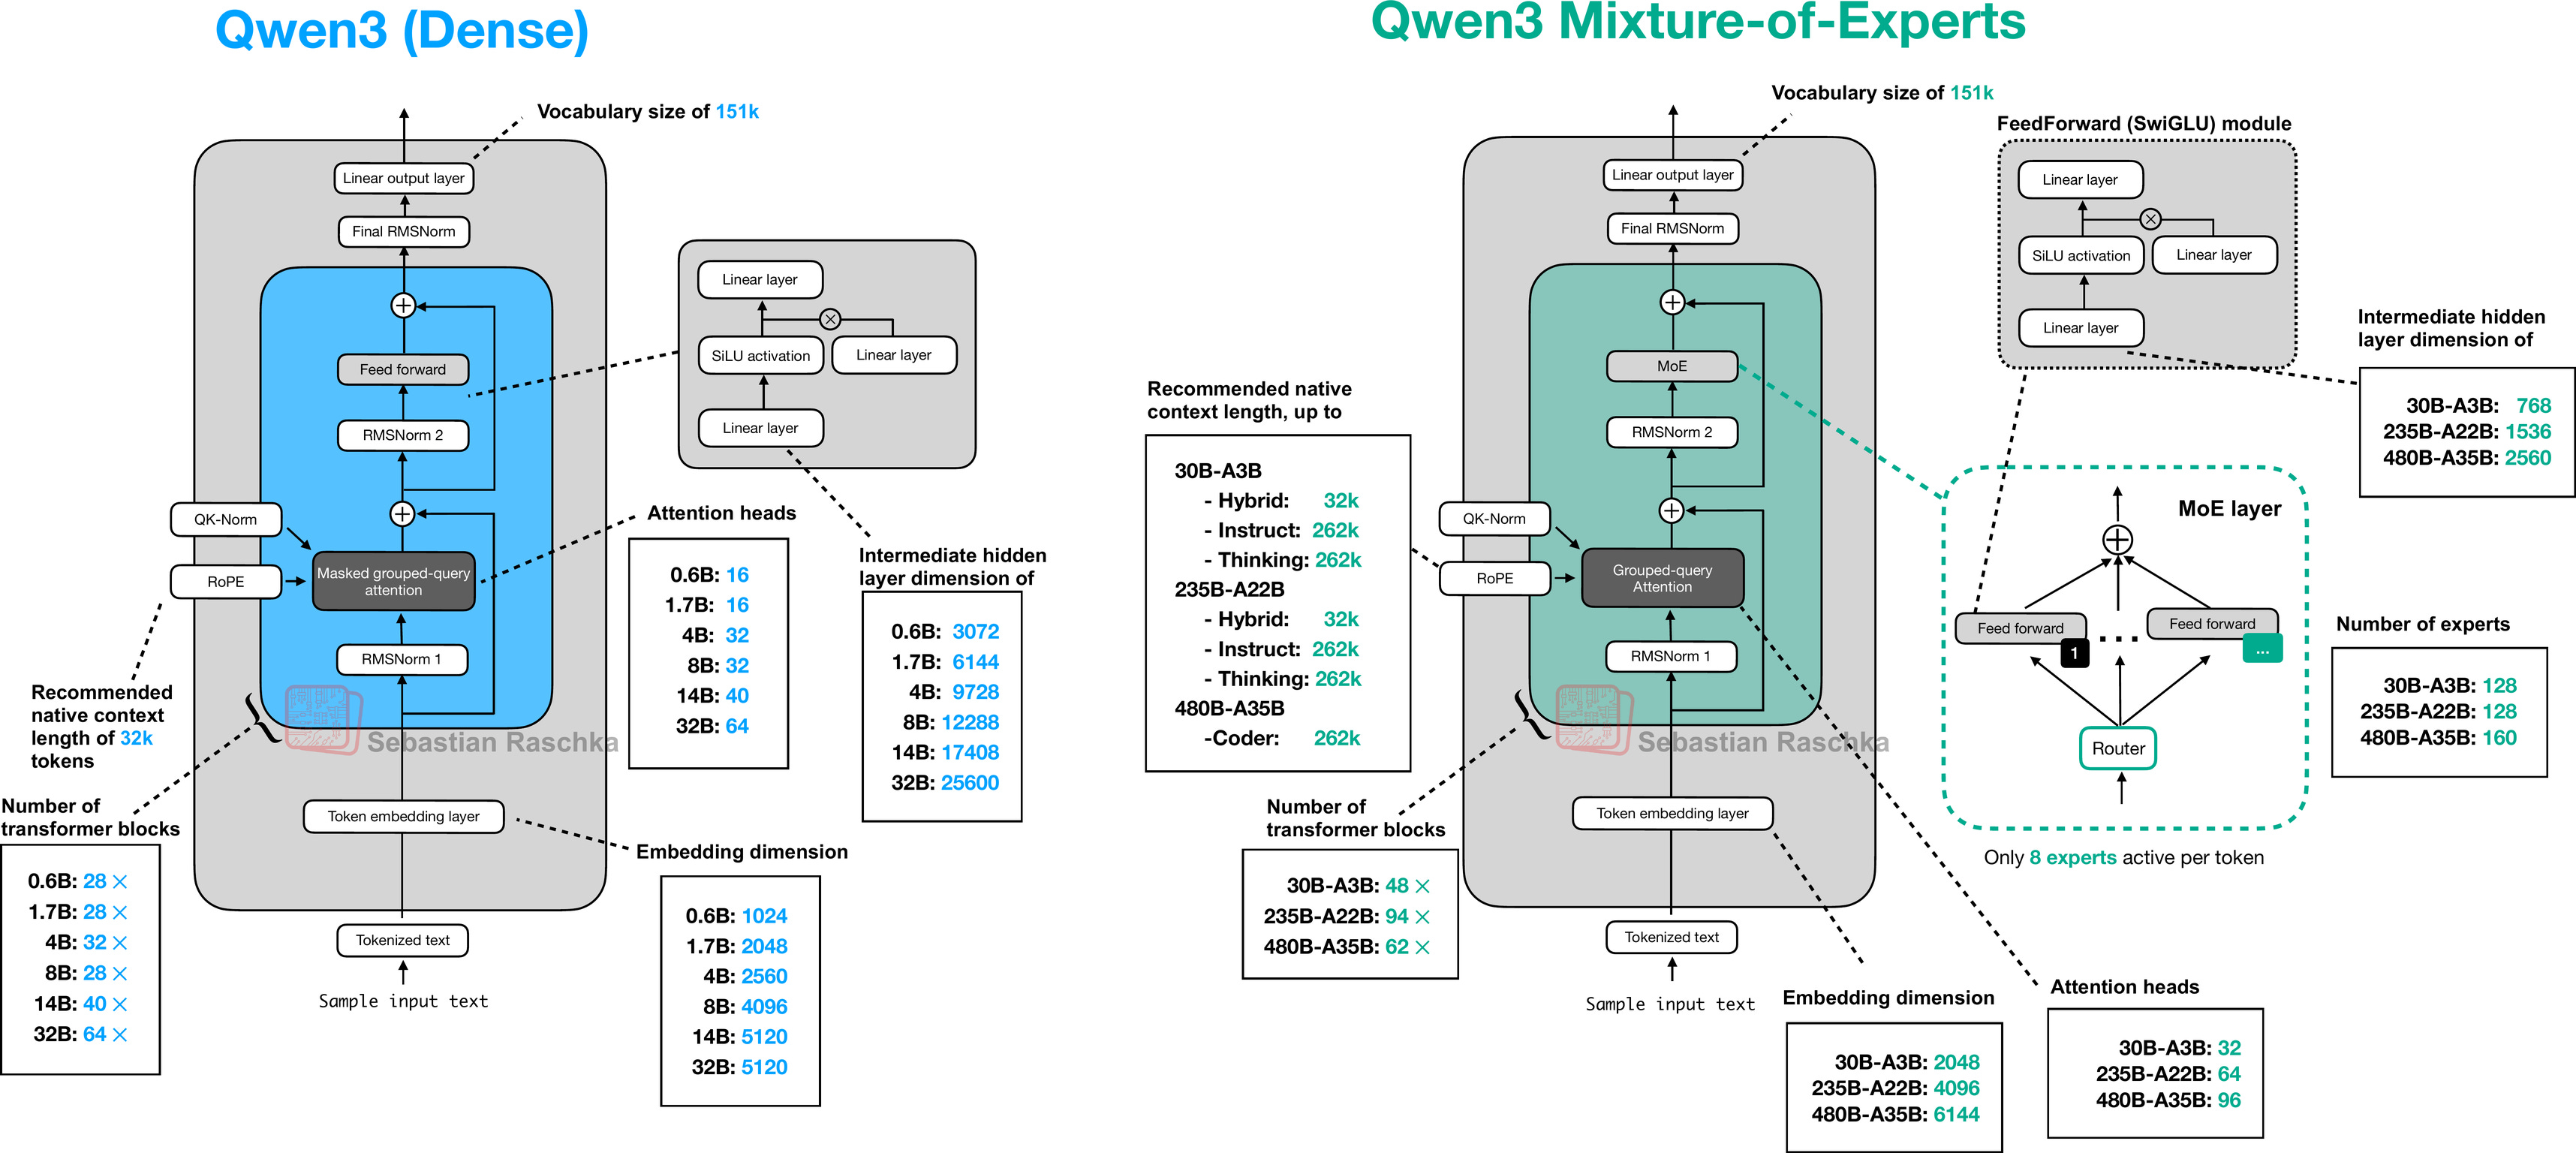
Bayliner1980, Qwen3-0.6B modelini MoE (Mixture of Experts) mimarisine dönüştürerek topluluğa yeni bir sürüm sundu. Dönüşüm sırasında chat yeteneklerini korumak ve paylaşımlı uzman eksikliğini telafi etmek için pseudo‑shared expert deneyi yapıldı. Benchmark sonuçları, MoE versiyonunun bazı ölçütlerde kalite kaybına yol açtığını gösteriyor.
Özetle
- 1
Qwen3-0.6B modeli MoE mimarisine dönüştürüldü, ancak kalite bazı metriklerde düşüş gösterdi.
- 2
Paylaşımlı uzman eksikliği pseudo‑shared expert ile kısmen telafi edildi.
- 3
Benchmark sonuçları, MoE sürümünün Wiki ve C4 perplexity'sinde %10-15 artış, görev başarısında ise hafif düşüş olduğunu ortaya koydu.
- 4
GPU hızında küçük modellerde fark yok, ancak daha büyük modellerde MoE dönüşümü hız kazancı sağlıyor.
Yerel LLaMA topluluğunun aktif bir üyesi olan Bayliner1980, daha önce Qwen2.5 modelleri için geliştirdiği qwen2moe aracını temel alarak Qwen3-0.6B modelini MoE mimarisine çevirdi. Bu süreçte en büyük zorluk, modelin sohbet (chat) yeteneklerini korumak ve Qwen3'ün paylaşımlı uzman (shared expert) katmanının olmamasını aşmaktı. Paylaşımlı uzman eksikliği, önceki dönüşümlerde kaliteyi sabit tutan bir mekanizma olduğundan, MoE versiyonunda belirgin bir performans düşüşüne neden oldu.
Bu sorunu hafifletmek için yazar, router'ın her zaman seçtiği bir "pseudo‑shared expert" tanımladı. Gerçek bir paylaşımlı uzman kadar etkili olmasa da, kaybedilen kaliteyi bir ölçüde geri kazandırdı. Ayrıca, kaliteyi GGUF uyumluluğu pahasına artırabilecek alternatif bir dönüşüm seti yayınlama planı da gündemde; bu set, yoğun katman (dense-layer) ikamesi gibi teknikleri içerecek.
Yapılan değerlendirmelerde, Qwen3-0.6B dense (standart) ve MoE sürümleri arasındaki farklar sayısal olarak ortaya kondu. Wiki perplexity (ppl) %23.88'den %26.98'e, C4 ppl %31.63'ten %36.32'ye yükselirken, görev başarısı (Task) skoru %0.455'ten %0.425'e düştü. İşlem hızı açısından ise GPU üzerinde dense model 377 t/s, MoE model 352 t/s; CPU üzerinde ise dense 115 t/s, MoE 124 t/s değerleri elde edildi. Küçük 0.6B modellerde hız kazancı görülmezken, daha büyük 1.5B modellerde MoE dönüşümünün fayda sağladığı belirtiliyor.
Modelin sınırlamaları da açıkça ifade edildi: belirli gerçekleri hatalı vermesi (örneğin Mona Lisa'nın 1519'da boyandığını söylemesi), kod üretiminde hatalar ve düşünme (thinking) modunun çalışmaması. Sonuç olarak, düşük parametreli bir model arayan kullanıcıların orijinal Qwen3-0.6B modelini tercih etmeleri önerildi. Yazar, projeyi desteklemek isteyenlerden Ko‑fi üzerinden bağış talep ediyor.
Yöney yorumu
MoE dönüşümü, özellikle büyük ölçekli modellerde performans ve maliyet avantajı sunabilir; ancak Qwen3-0.6B gibi küçük modellerde kalite kaybı, bu yaklaşımın her durumda tercih edilmemesi gerektiğini gösteriyor.
Haberdeki skorlar
Bu skorların kaynak metinde birebir geçtiği doğrulandı. Bilinen testlerin sonuçları Benchmark sıralamalarına da eklenir.
- Qwen3-0.6B denseWiki ppl23.88 ppl
- Qwen3-0.6B MoEWiki ppl26.98 ppl
- Qwen3-0.6B denseC4 ppl31.63 ppl
- Qwen3-0.6B MoEC4 ppl36.32 ppl
- Qwen3-0.6B denseTask metric0.455
- Qwen3-0.6B MoETask metric0.425
- Qwen3-0.6B denseGPU throughput · GPU generation377 t/s
- Qwen3-0.6B MoEGPU throughput · GPU generation352 t/s
- Qwen3-0.6B denseCPU throughput · CPU generation115 t/s
- Qwen3-0.6B MoECPU throughput · CPU generation124 t/s
Bu haber Reddit LocalLLaMA kaynağından derlenip Türkçeye aktarıldı. Ayrıntılar ve orijinal metin için oka tıklayın.